Für Fortgeschrittene: Wie funktionieren Indikatoren?
Du lernst aus dem Quellcode von SMA, EMA, RSI, MACD, ATR und Bollinger-Bändern und entwickelst eine eigene Variante.
Ein Indikator lässt sich leichter weiterentwickeln, wenn du verstehst, wie sein Wert entsteht. Welche Daten gehen in die Berechnung ein? Was merkt er sich für die nächste Kerze? Was verändert sich mit einem anderen Durchschnitt oder einer anderen Kursquelle? Auch diese Fragen beantwortet der Quellcode.
Die Bibliothek ta von PyneCore ist in Pyne code geschrieben. Die dortigen Variablen mit Persistent, Funktionsaufrufe und Bedingungen verwenden die im Buch gelernte Funktionsweise. Der gesamte Quellcode ist verfügbar. Du kannst deshalb einen fertigen Indikator genauso nachvollziehen wie dein eigenes Programm.
Dieses Kapitel richtet sich an Fortgeschrittene und erklärt das Lesen von Quellcode und das Experimentieren damit. Du musst nicht die ganze Bibliothek auf einmal verstehen. Beginne mit einer kurzen Funktion und verfolge dann die Aufrufe, auf denen sie aufbaut.
Öffne die tatsächliche Implementierung
- Öffne die zuvor angelegte Datei
moving_averages.pyin der PyneIDE. - Halte in der Zeile
ta.ema(close, 10)unter macOS Command, unter Windows oder Linux Ctrl gedrückt und klicke aufema. Du kannst auch Go to Definition im Rechtsklickmenü verwenden. - Der Editor öffnet die Datei
ta.pyder installierten PyneCore-Bibliothek bei der Definition vonema. - Lies die Funktionsbeschreibung und anschließend den Rumpf. Ruft sie eine weitere Funktion auf, kannst du auch zu deren Definition springen.
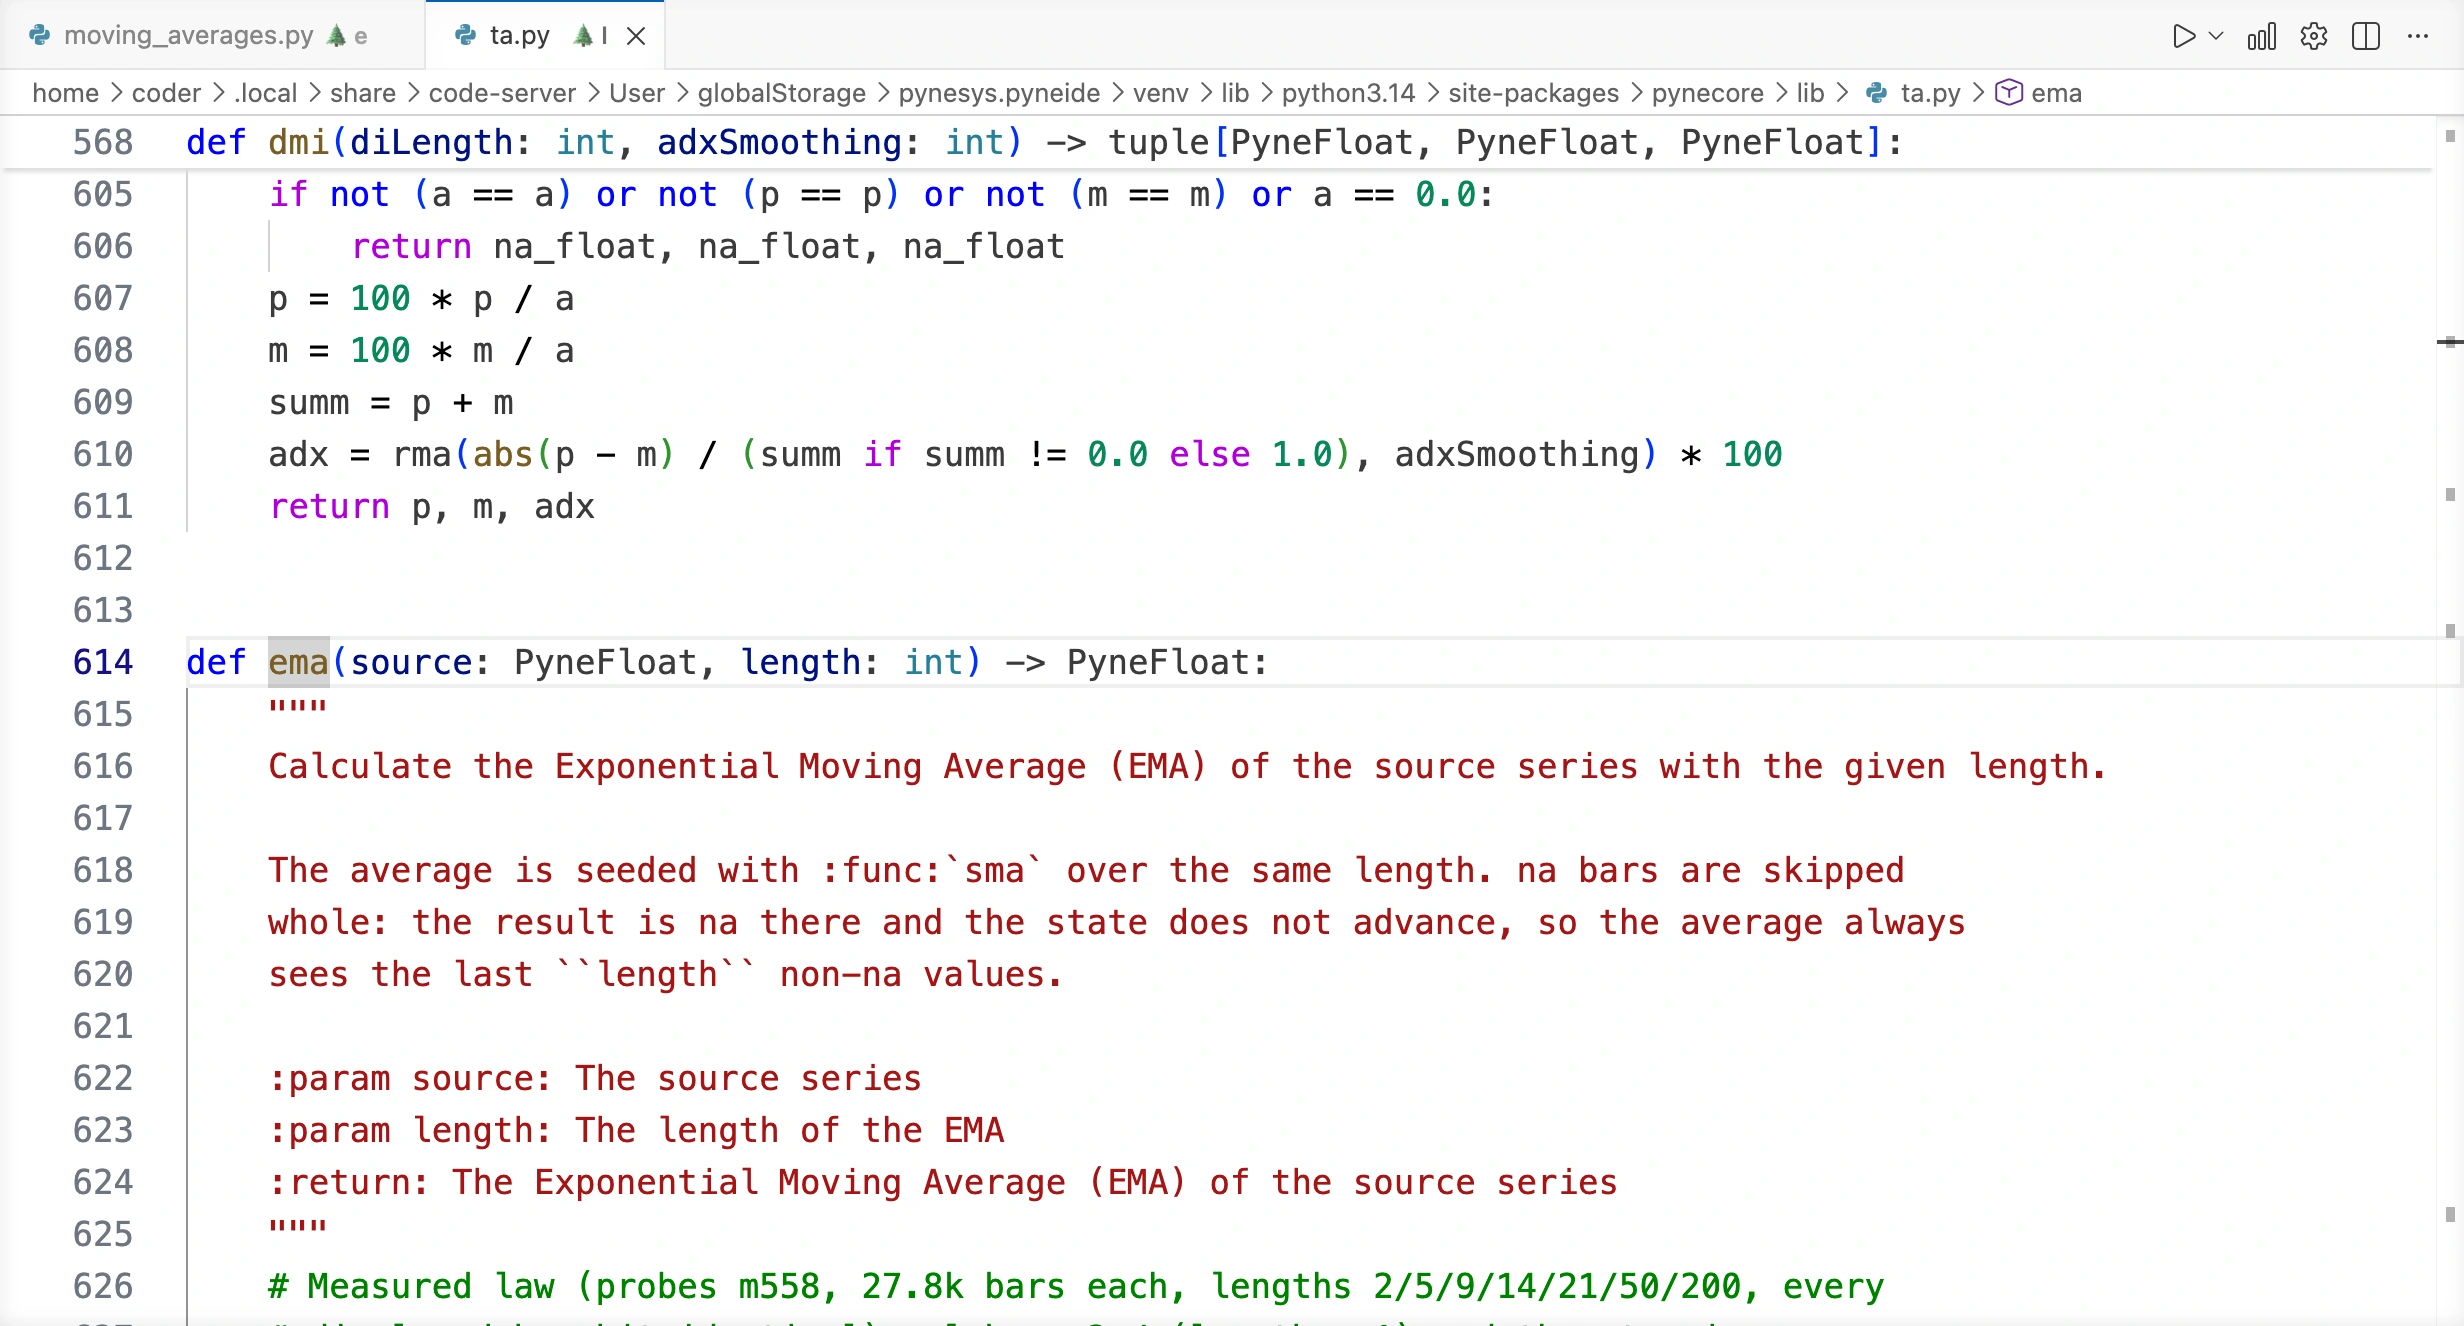
Das Ansehen der Parameter und den Sprung zur Definition hast du im Kapitel Hilfe beim Schreiben von Code ausprobiert. Dieselbe Aktion führt auch bei RSI, MACD und den übrigen Funktionen zum Quellcode. Die vollständige Referenz zu ta hilft beim Suchen von Funktionen und Verstehen ihrer Parameter.
Bibliothekscode und Edge: Am Anfang von ta.py findest du @pyne lib. Die Bibliothek ist nicht auf den eingeschränkten Edge-Sprachumfang begrenzt: Sie verwendet auch allgemeine Python-Werkzeuge, interne Hilfsfunktionen und weitere Typangaben. Ihre kerzenweise Funktionsweise und Zustandsverwaltung werden dir aber bekannt vorkommen. PyneFloat ist beispielsweise die Typangabe der Bibliothek für Zahlen, na_float bezeichnet einen fehlenden Zahlenwert.
Die folgenden Quellcodeausschnitte zeigen Berechnungen der Bibliothek und sind keine vollständigen Edge-Programme. Schreibe für eine eigene Edge-Variante den verstandenen Algorithmus mit den erlaubten Werkzeugen. Lasse die installierte Datei ta.py unverändert und experimentiere in eigenen Dateien.
SMA: die Summenbildung hinter der Formel
Zwei Zeilen der Berechnung von ta.sma:
length = int(length)
return lib_math.sum(source, length) / length
Der Durchschnitt ist die Fenstersumme geteilt durch die Elementanzahl. Nach dem Umwandeln der Länge in eine ganze Zahl übernimmt lib_math.sum die Summenbildung. Den Zustand findest du hier nicht im Rumpf von sma: Ihn verwaltet die aufgerufene Summenberechnung. Wenn du den Aufruf weiterverfolgst, gelangst du über math.py zur Implementierung in _math_stateful.py.
Das ist eine wichtige Gewohnheit beim Lesen: Auch eine kurze Funktion kann Zustand haben. Das Verhalten der aufgerufenen Funktionen gehört zur Berechnung. Der selbst geschriebene gleitende Durchschnitt addierte die Werte desselben Fensters in einer eigenen Schleife.
EMA und RMA: den gespeicherten Durchschnitt aktualisieren
Nach der Aufwärmphase führt der EMA diesen Schritt aus:
last_val = last_val + alpha * (source - last_val)
return last_val
last_val ist der vorherige Durchschnitt, source der aktuelle Wert. Wir ändern den alten Durchschnitt um einen Anteil ihrer Differenz. Beim EMA beträgt alpha genau 2 / (length + 1). Mit Länge zehn addieren wir also ungefähr 18,18 Prozent der Differenz zwischen neuem Kurs und altem Durchschnitt zum alten Wert.
Im Quellcode sind sowohl alpha als auch last_val als Persistent gekennzeichnet. Anfangs fehlt last_val. Die Funktion versucht deshalb zunächst, den Wert mit einem SMA derselben Länge zu setzen:
if not (last_val == last_val):
    last_val = sma(source, length)
    return last_val
Solange auch für den SMA nicht genügend Daten vorhanden sind, fehlt das Ergebnis. Sobald der anfängliche Durchschnitt bereitsteht, aktualisieren wir den vorherigen Wert. not (last_val == last_val) prüft auf einen fehlenden Wert: Dieser ist nicht gleich sich selbst. In eigenen Beispielen hast du dafür na(value) verwendet.
Der RMA, auch Wilder-Glättung genannt, beginnt ähnlich, aktualisiert sich aber anders:
last_val = (last_val * (length - 1) + source) / length
return last_val
Bei Länge zehn hat der neue Wert ein Gewicht von einem Zehntel. Beim EMA ist das Gewicht bei gleicher Länge größer. Deshalb reagieren beide Glättungen auf dieselbe Kursfolge unterschiedlich.
Im vollständigen Quellcode findest du auch die Behandlung fehlender Eingaben und den Sonderfall für Länge eins. Sogar eigene Varianten mit derselben Formel können unterschiedliche Ergebnisse liefern, wenn sie mit anderen Anfangswerten starten, fehlende Werte anders behandeln oder nicht auf denselben Kerzen laufen. Auch die Reihenfolge der Gleitkommaoperationen zählt; behalte sie für einen genauen Vergleich bei.
RSI: zwei getrennt geglättete Veränderungen
Der RSI behandelt Anstieg und Rückgang seiner Quelle getrennt. In PyneCore sind dies die zentralen Berechnungszeilen:
rma_u = rma(builtins.max(source - prev_src, 0.0), length)
rma_d = rma(builtins.max(prev_src - source, 0.0), length)
prev_src = source
prev_src ist der vorherige gültige Quellwert und wird als Persistent gespeichert. Steigt der Kurs von 100 auf 103, beträgt die Aufwärtsänderung 3 und die Abwärtsänderung 0. Fällt er von 103 auf 101, sind es 0 und 2. Der RMA glättet beide Reihen getrennt; die beiden Aufrufstellen haben eigenen Zustand.
prev_src wird erst nach der Berechnung beider Differenzen aktualisiert. Das ist dieselbe Reihenfolge wie in der Zusatzaufgabe zum persistenten vorherigen Wert.
Aus dem Verhältnis der geglätteten Änderungen entsteht der RSI:
if rma_d <= 1e-10:
    return 100.0
if rma_u <= 1e-10:
    return 0.0

return 100 - 100 / (1 + rma_u / rma_d)
Fehlt eine Abwärtsbewegung, ergibt sich 100; fehlt eine Aufwärtsbewegung, ergibt sich 0. Der Quellcode behandelt auch sehr kleine Werte und prüft die Abwärtsseite zuerst: Liegen beide Seiten unter dem Grenzwert, ist das Ergebnis 100. Aus einer bloßen Formel wären diese Details nicht ersichtlich.
Aus dem ersten gültigen Kurs gibt es noch keine Veränderung. Deshalb speichert der RSI ihn zunächst und kann beide Glättungen erst mit dem nächsten Wert beginnen. Die Anzahl der Veränderungen bestimmt seine Aufwärmphase. Der RSI zeigt keine Wahrscheinlichkeit: Ein Wert von 70 bedeutet keine 70-prozentige Chance auf einen Kursanstieg.
MACD: ein neuer Indikator aus gleitenden Durchschnitten
Der MACD berechnet die Differenz zweier EMA-Werte und bildet davon wiederum einen EMA. Die wesentlichen Berechnungsschritte ohne Prüfungen auf fehlende Werte:
fast = ema(source, fastlen)
slow = ema(source, slowlen)
macd_val = fast - slow
signal = ema(macd_val, siglen)
Die drei Rückgabewerte:
return macd_val, signal, macd_val - signalDie MACD-Linie ist die Differenz zwischen schnellem und langsamem Durchschnitt. Die Signallinie ist ihre geglättete Variante. Das Histogramm ist die Differenz beider Linien und daher null, wenn beide denselben Wert haben.
Ein Aufruf liefert drei Ergebnisse, die du in drei Variablen übernehmen kannst:
macd_line, signal_line, histogram = ta.macd(close, 12, 26, 9)Die Reihenfolge zählt: MACD-Linie, Signallinie, Histogramm. Solange die beiden Kursdurchschnitte nicht bereitstehen, fehlt auch die Differenz. Danach hat die Signallinie noch ihre eigene Aufwärmphase. Anfängliche Lücken eines zusammengesetzten Indikators ergeben sich so auch aus seinen inneren Berechnungen.
ATR: Auch ein Kurssprung gehört zur Spanne
Die Implementierung des ATR ist kurz:
return rma(tr(True), length)Den RMA kennst du bereits. Hier glättet er die True Range, also die wahre Handelsspanne. Diese ist das Maximum der folgenden drei Abstände:
- Differenz zwischen aktuellem Hoch und Tief;
- Abstand des aktuellen Hochs zum vorherigen Schlusskurs;
- Abstand des aktuellen Tiefs zum vorherigen Schlusskurs.
Ist der vorherige Schlusskurs 100, das aktuelle Tief 108 und das Hoch 110, beträgt die eigene Spanne der Kerze nur 2. Die True Range ist aber max(2, 10, 8), also 10: Sie berücksichtigt auch den Kurssprung seit dem vorherigen Schluss.
Auf der ersten Kerze mit fehlendem vorherigem Schlusskurs verwendet tr(True) den Wert high - low. Der Quellcode liest den vorherigen Schlusskurs aus einer internen Angabe der Laufzeit. Der ATR zeigt die Größe der Bewegung in Kurseinheiten, nicht ihre Richtung.
Bollinger-Bänder: Durchschnitt und Standardabweichung
Die Mittellinie von ta.bb ist ein SMA; die beiden Grenzen liegen um ein bestimmtes Vielfaches der Standardabweichung davon entfernt. Der Quellcode berechnet zuerst Standardabweichung und Durchschnitt:
std_dev = stdev(series, length)
middle = sma(series, length)
Die Rückgabe bei gültigem Mittelwert:
std_dev *= mult
return middle, middle + std_dev, middle - std_dev
Die Standardabweichung beschreibt, wie stark die Fensterwerte um den Durchschnitt streuen. Bei Mitte 100, Standardabweichung 3 und Multiplikator 2 ist die obere Grenze 106 und die untere 94. Auch dieser Aufruf liefert drei Werte, aber in anderer Reihenfolge als MACD: Mitte, obere Grenze, untere Grenze.
Eigene Variante: Reproduziere zuerst das Original
Lege bands_workshop.py an. Unsere eigene Funktion setzt die Bänder aus einfacheren Bibliotheksfunktionen zusammen. Daneben berechnen wir die obere Grenze des fertigen ta.bb als Vergleich.
"""
@pyne edge
"""
from pynecore.lib import close, color, input, plot, script, ta


def custom_bands(source: float, length: int, multiplier: float) -> tuple[float, float, float]:
    middle = ta.sma(source, length)
    deviation = ta.stdev(source, length)
    upper = middle + multiplier * deviation
    lower = middle - multiplier * deviation
    return middle, upper, lower


@script.indicator("Bands Workshop", overlay=True)
def main(
    length: int = input.int(20, title="Length", minval=2, maxval=200),
    multiplier: float = input.float(2.0, title="Deviation multiplier", minval=0.1, maxval=5.0),
):
    builtin_middle, builtin_upper, builtin_lower = ta.bb(close, length, multiplier)
    own_middle, own_upper, own_lower = custom_bands(close, length, multiplier)
    plot(builtin_upper, "Built-in upper", color=color.blue, linewidth=3)
    plot(own_upper, "Custom upper", color=color.orange)
    plot(own_middle, "Custom middle", color=color.green)
    plot(own_lower, "Custom lower", color=color.gray)
tuple[float, float, float] bezeichnet den Typ eines Ergebnisses aus drei Zahlen. Die Zeile return middle, upper, lower gibt dieses Tripel zurück; die drei Variablennamen vor dem Aufruf übernehmen die Werte einzeln. builtin_middle und builtin_lower zeichnen wir jetzt nicht, du kannst sie aber später ebenfalls zur Prüfung verwenden.
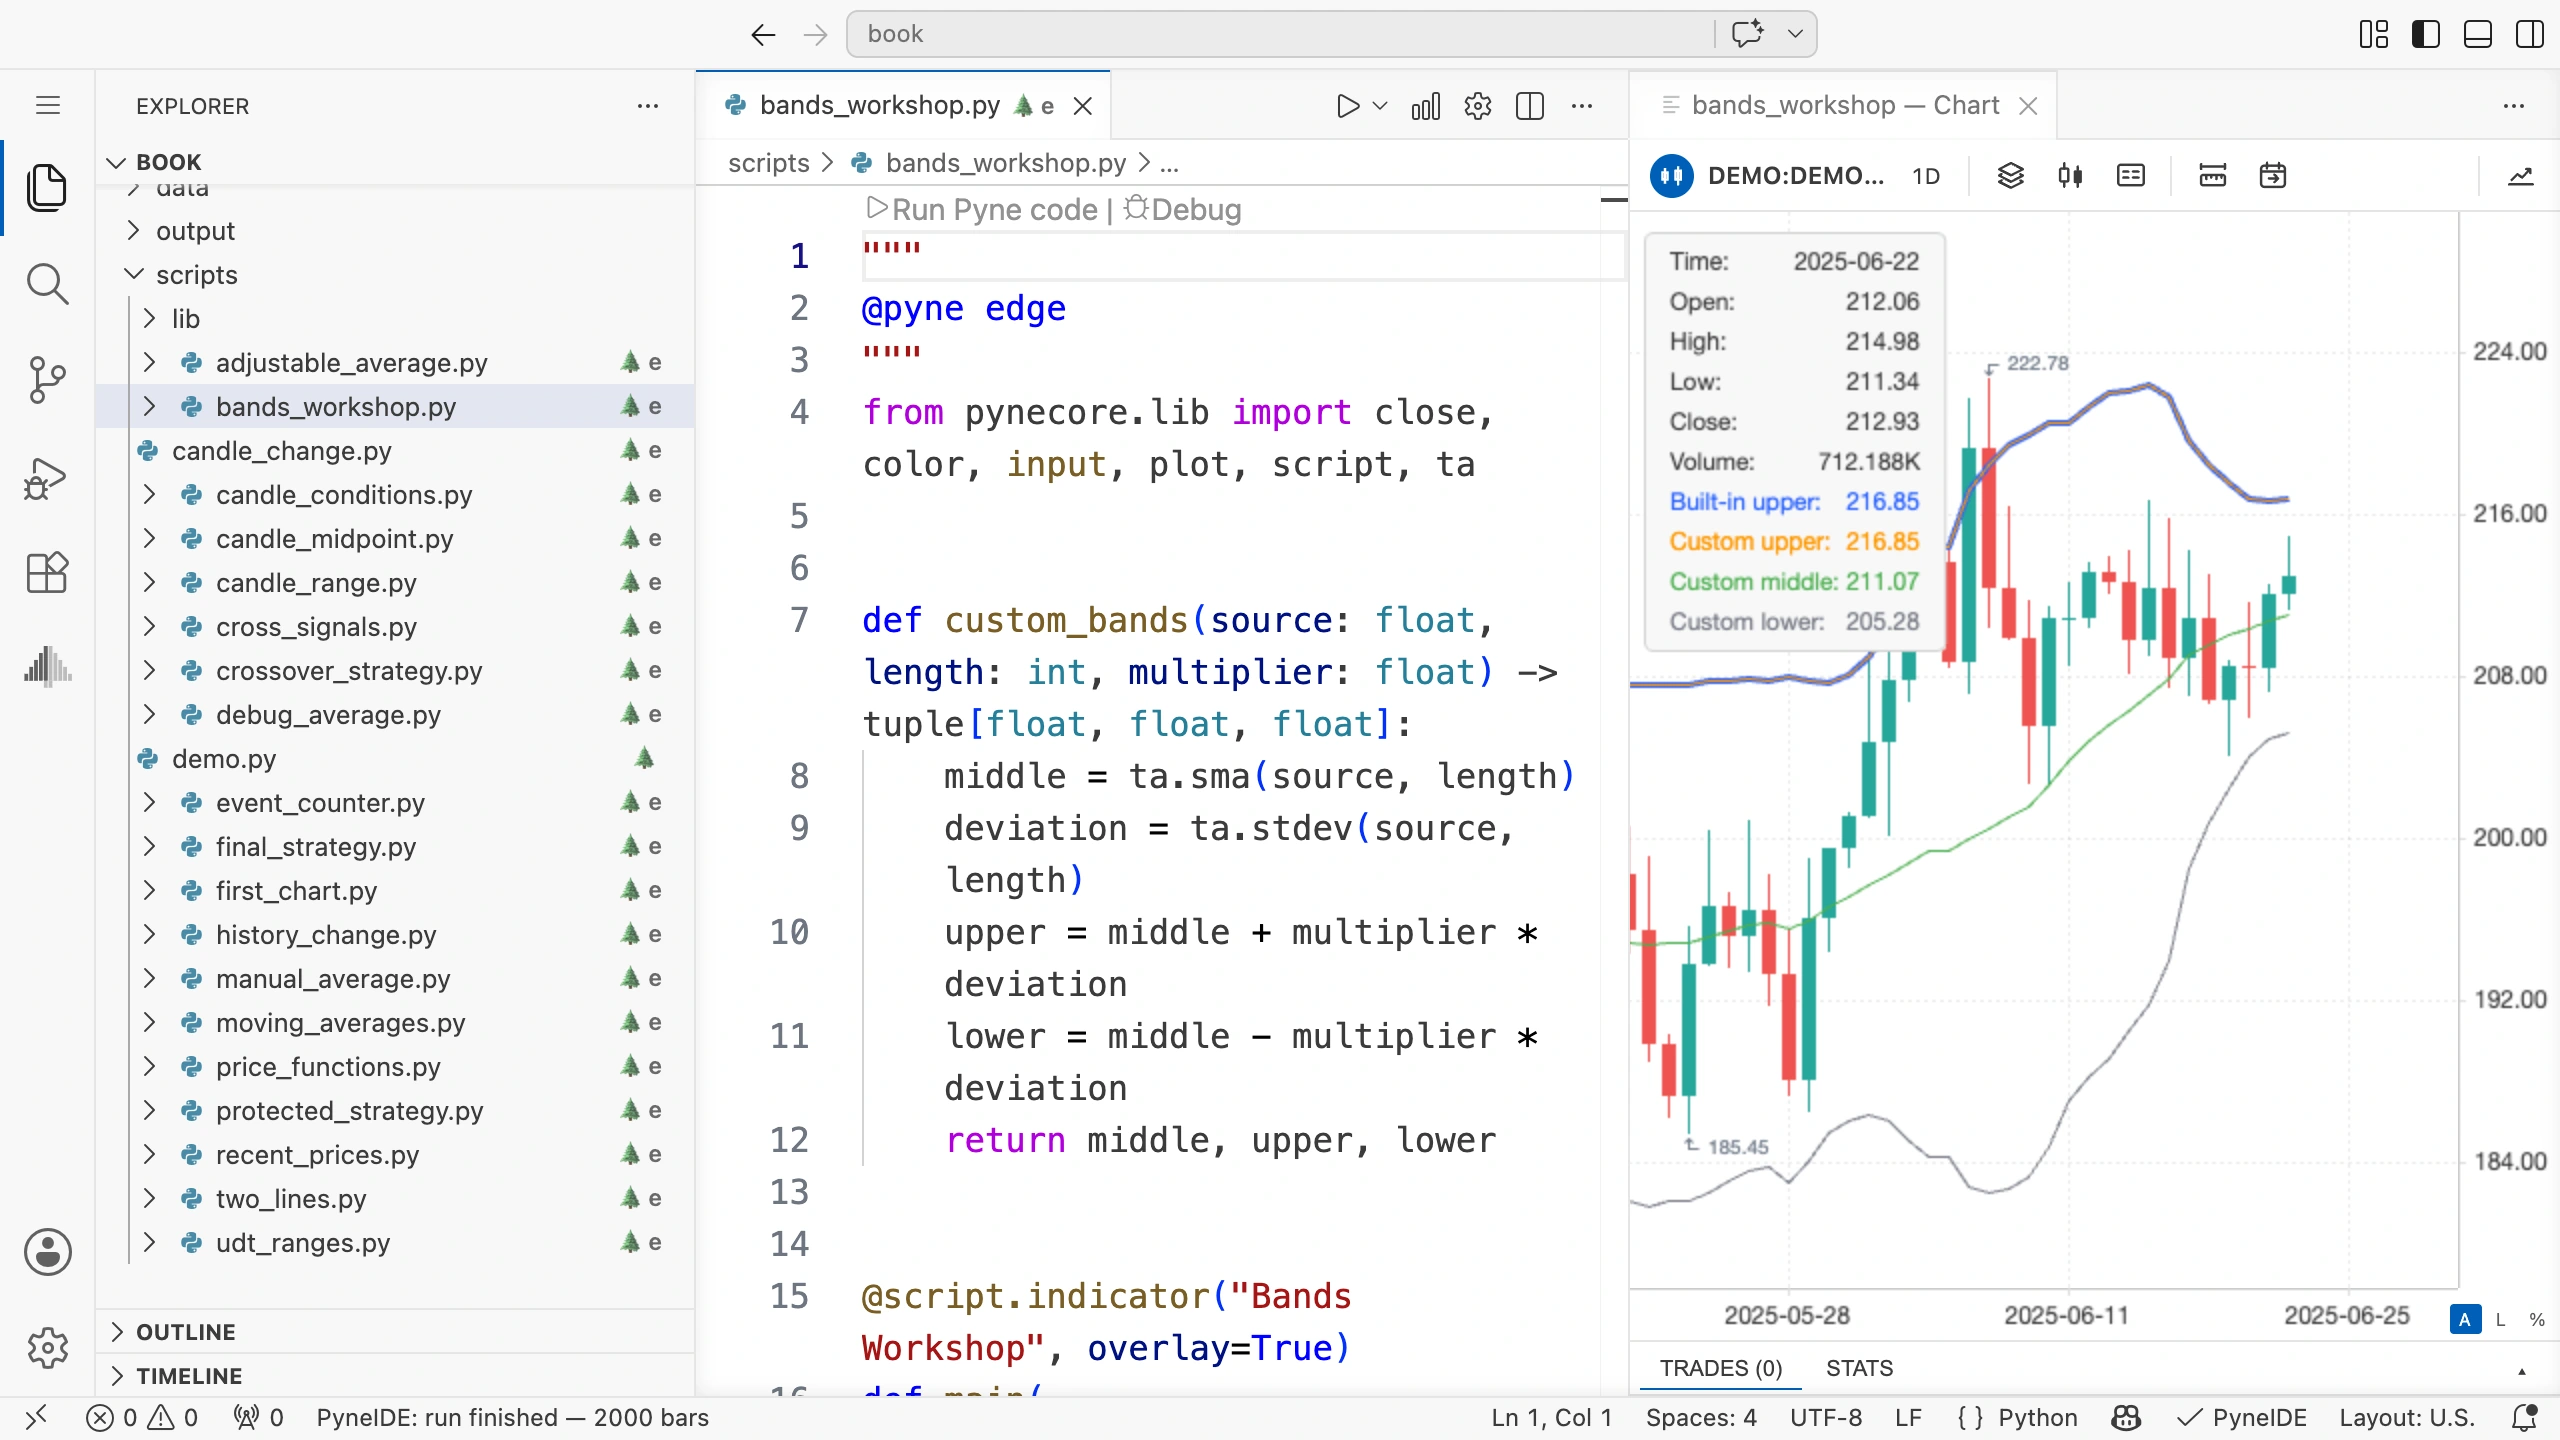
Führe das Programm auf den Demodaten aus. Eigene und fertige obere Grenze liegen aufeinander; die dünne orangefarbene Linie verläuft auf der dickeren blauen. Bewege den Mauszeiger auf eine Kerze und vergleiche Built-in upper mit Custom upper. Bei Länge zwanzig fehlt auf den ersten neunzehn Kerzen noch ein vollständiges Fenster.
Für eine genauere Prüfung öffne die ausgegebenen Werte über Open plot output CSV in der Chart-Werkzeugleiste. Prüfe bei einer eigenen Variante sowohl den ersten gültigen Punkt als auch spätere Werte. Selbst bei optisch identischen Linien können kleine Unterschiede bestehen.
Probiere es selbst aus: eine EMA-Mittellinie
Ändere nur die Mittellinie von custom_bands: Verwende EMA statt SMA. Behalte Standardabweichungsberechnung und den fertigen Aufruf von ta.bb zum Vergleich bei.
Sage vor dem Start voraus: Wird deine obere Grenze weiterhin durchgehend auf der fertigen liegen? Was passiert nach einer plötzlichen Kursänderung?
Lösung der Aufgabe
Die erste Berechnungszeile der eigenen Funktion:
middle = ta.ema(source, length)Die beiden Grenzen werden von diesem EMA aus gemessen, während ta.stdev unverändert bleibt. Deine Mittellinie und Grenzen verschieben sich dadurch gewöhnlich gegenüber den ursprünglichen Bändern. Die Differenz der beiden oberen Werte entspricht der Differenz zwischen EMA und SMA, weil wir dieselbe Standardabweichung mit demselben Multiplikator addieren.
Das ist bereits deine eigene Versuchsvariante. Die andere Linie allein zeigt noch nicht, ob eine Handelsregel damit besser abschneidet. Das kannst du in einer eigenen Strategie mit denselben Daten und Einstellungen untersuchen.
So liest du in der Bibliothek weiter
Wähle einen Indikator und beschreibe in eigenen Worten, welche Daten er erhält, was er speichert und welches Ergebnis er liefert. Verfolge die internen Aufrufe, bis du die Berechnung verstehst. Beim RSI führt dich beispielsweise rsi → rma → sma von den Differenzen über die Glättung bis zum Anfangswert.
Lies auch die Zweige für fehlende Werte, Aufwärmphase und Grenzfälle. Wenn du eine eigene Variante erstellst, ändere zunächst nur ein Detail und vergleiche sie dann mit dem Original. So unterscheidest du eine beabsichtigte Veränderung von einem Rechenfehler.
Auch den Quellcode der übrigen Bibliotheksfunktionen erreichst du per Command- oder Ctrl-Klick. Für einen längeren Indikator brauchst du womöglich mehr Zeit, aber die Lesereihenfolge bleibt gleich: Eingaben, gespeicherte Daten, Berechnung, Ergebnis.