Approfondissement : comment fonctionnent les indicateurs ?
Étudiez le code des SMA, EMA, RSI, MACD, ATR et bandes de Bollinger, puis créez votre propre variante.
Il est plus facile de faire évoluer un indicateur quand on comprend comment sa valeur est calculée. Quelles données entrent dans le calcul ? Que conserve-t-il pour la bougie suivante ? Que change une autre moyenne ou une autre source de prix ? Le code source répond aussi à ces questions.
La bibliothèque ta de PyneCore est écrite en Pyne code. Ses variables Persistent, appels de fonctions et conditions reposent sur le fonctionnement appris dans le livre. Tout le code est accessible : vous pouvez suivre un indicateur existant comme votre propre programme.
Ce chapitre avancé enseigne à lire le code et à expérimenter. Vous n’avez pas à comprendre toute la bibliothèque d’un coup. Commencez par une fonction courte, puis suivez les appels sur lesquels elle repose.
Ouvrir l’implémentation réelle
- Ouvrez dans PyneIDE le fichier
moving_averages.pycréé précédemment. - Dans
ta.ema(close, 10), maintenez Command sur macOS ou Ctrl sous Windows ou Linux, puis cliquez surema. Vous pouvez aussi utiliser Go to Definition dans le menu contextuel. - L’éditeur ouvre le fichier
ta.pydu PyneCore installé à la définition deema. - Lisez la description, puis le corps. Si une autre fonction est appelée, vous pouvez aussi rejoindre sa définition.
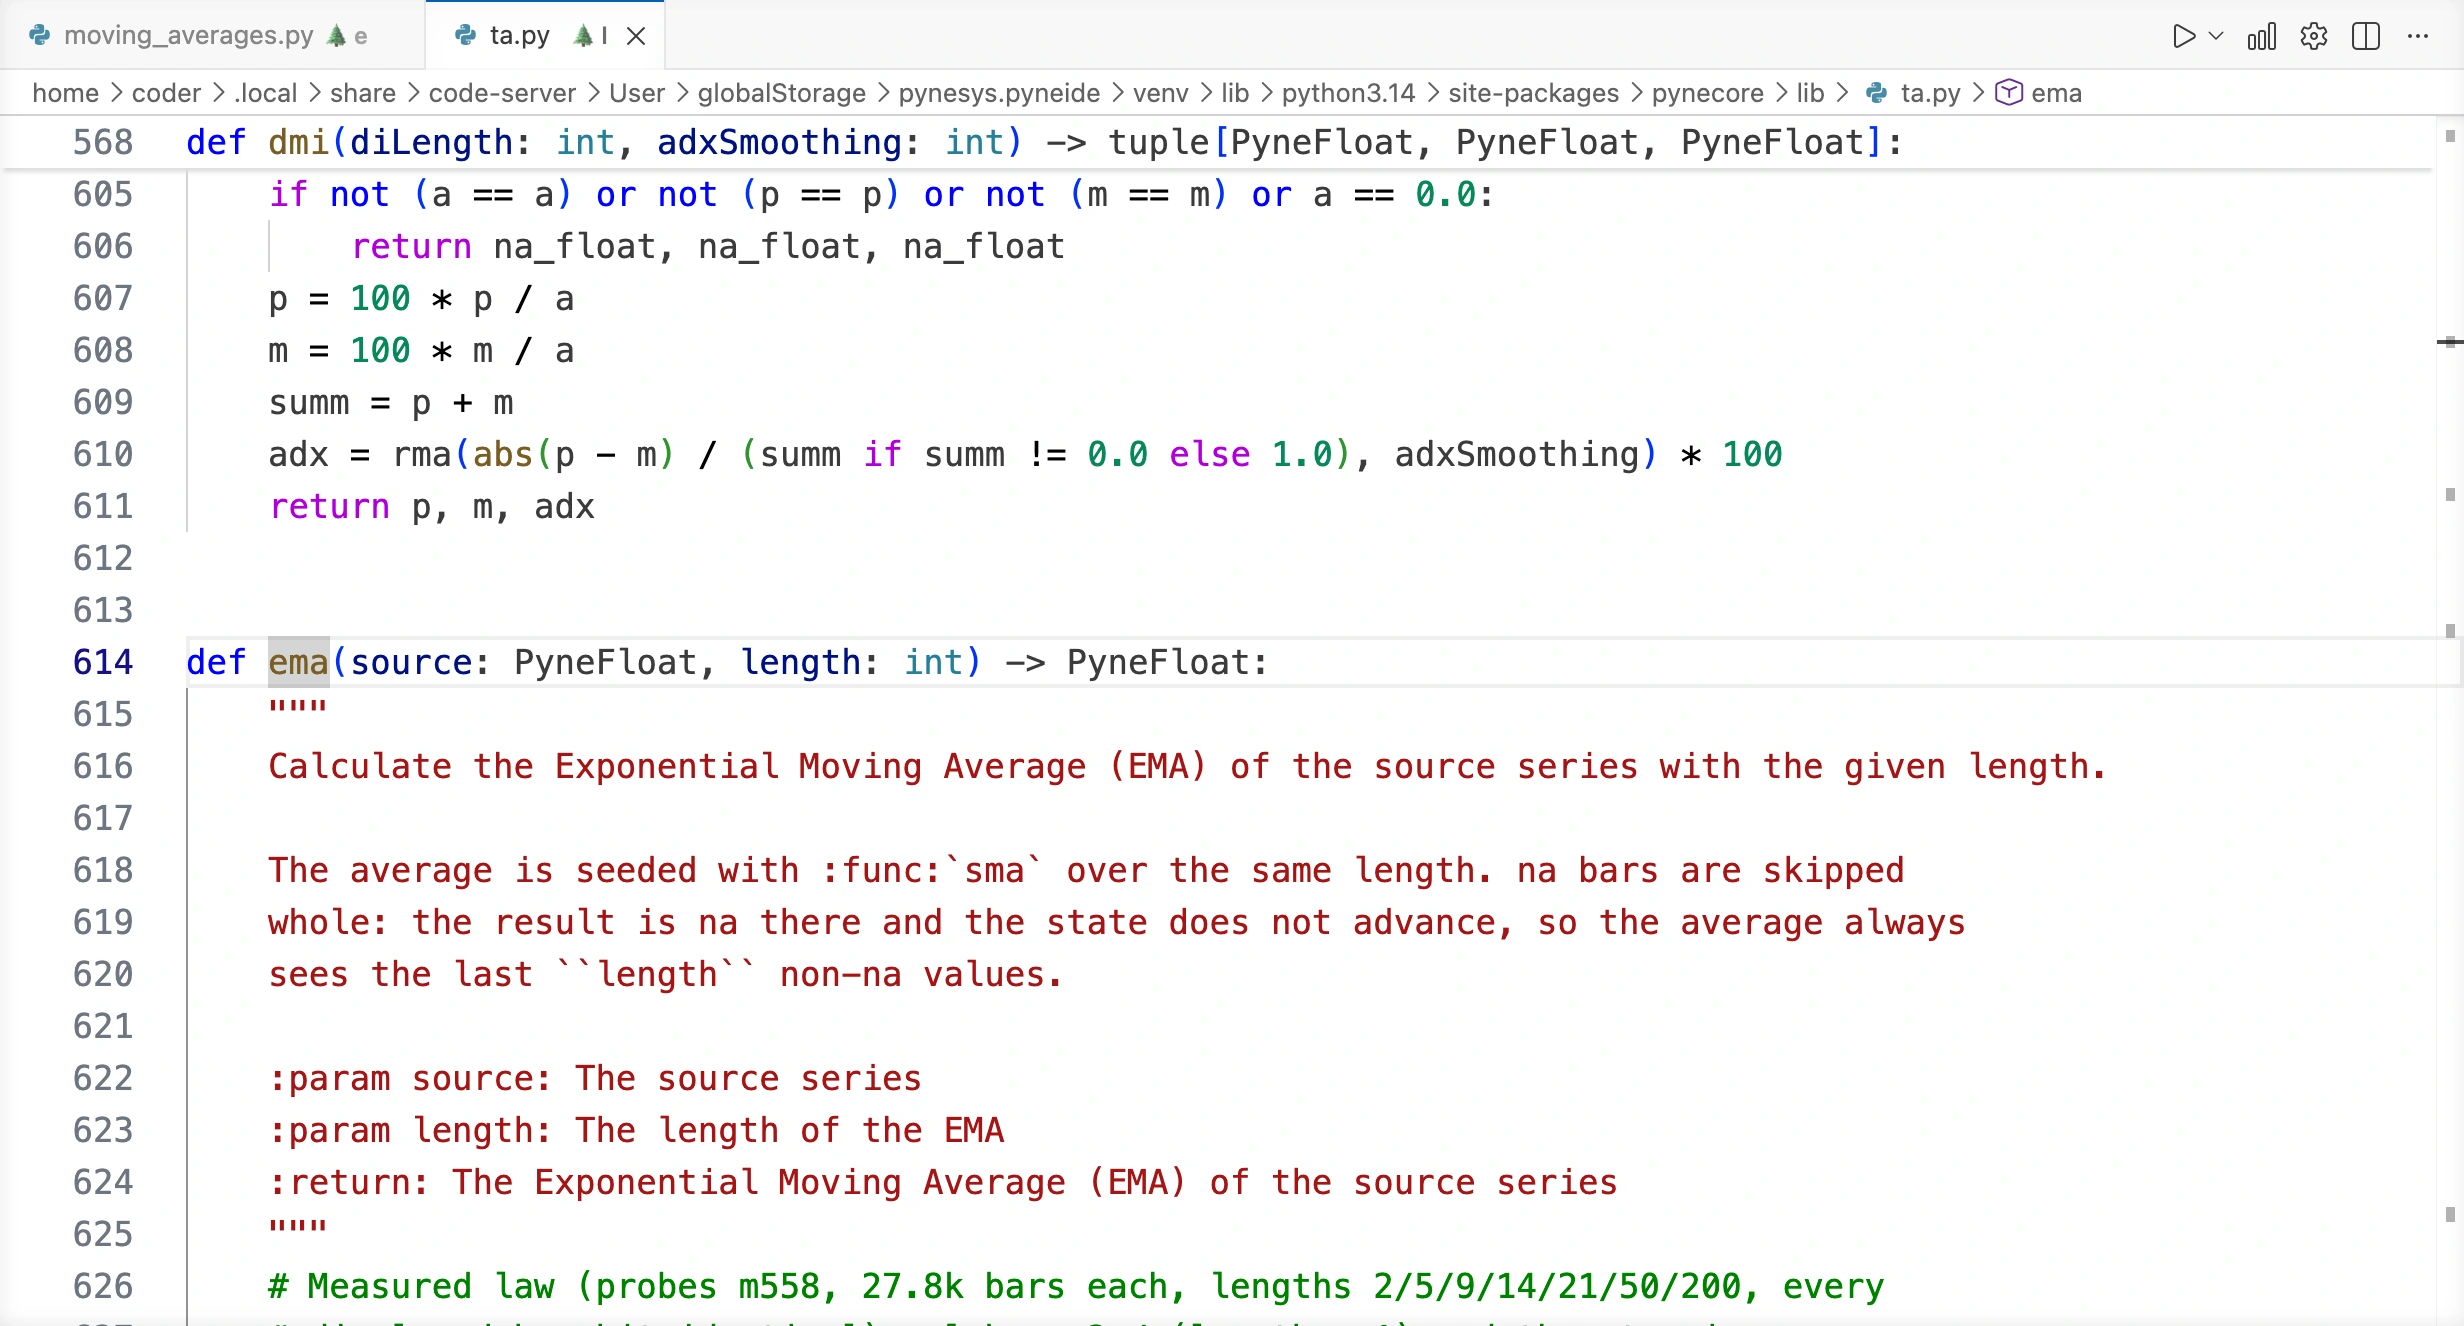
Vous avez déjà consulté les paramètres et ouvert les définitions dans De l’aide pendant l’écriture du code. La même action ouvre aussi les sources du RSI, du MACD et des autres fonctions. La référence complète de ta aide à les retrouver et à comprendre leurs paramètres.
Le code de bibliothèque et Edge : ta.py commence par @pyne lib. La bibliothèque n’est pas écrite avec les règles restreintes d’Edge : elle utilise aussi des outils Python généraux, des fonctions internes et d’autres annotations de type. Son exécution bougie par bougie et sa gestion d’état vous seront pourtant familières. PyneFloat est par exemple une annotation de type numérique de la bibliothèque ; na_float désigne une valeur numérique manquante.
Les extraits suivants montrent les calculs de la bibliothèque ; ce ne sont pas des programmes Edge complets. Pour créer une variante Edge, réécrivez l’algorithme compris avec les outils autorisés. Laissez intact le fichier ta.py installé et expérimentez dans vos propres fichiers.
SMA : la somme derrière la formule
Les deux lignes du calcul de ta.sma :
length = int(length)
return lib_math.sum(source, length) / length
La moyenne est la somme de la fenêtre divisée par le nombre d’éléments. Après la conversion de la longueur en entier, lib_math.sum effectue la somme. L’état n’est pas dans le corps de sma : il est géré par la fonction de sommation appelée. En suivant l’appel, vous passez par math.py et atteignez l’implémentation de _math_stateful.py.
C’est une habitude de lecture à prendre : une fonction courte peut avoir un état. Les fonctions qu’elle appelle font aussi partie du calcul. La moyenne mobile écrite à la main additionnait les valeurs de cette même fenêtre avec une boucle.
EMA et RMA : actualiser la moyenne conservée
Après l’initialisation, l’EMA effectue :
last_val = last_val + alpha * (source - last_val)
return last_val
last_val est la moyenne précédente ; source, la valeur actuelle. Nous ajustons l’ancienne moyenne d’une fraction de leur différence. Dans l’EMA, alpha vaut 2 / (length + 1). Pour une longueur de dix, on ajoute donc environ 18,18 % de la différence entre le nouveau prix et l’ancienne moyenne.
Dans le code, alpha et last_val sont des variables Persistent. last_val manque au départ ; la fonction essaie donc d’abord de l’initialiser avec une SMA de même longueur :
if not (last_val == last_val):
    last_val = sma(source, length)
    return last_val
Tant que la SMA manque aussi de données, le résultat est manquant. Une fois la moyenne initiale disponible, nous actualisons la valeur précédente. not (last_val == last_val) teste l’absence : une valeur manquante n’est pas égale à elle-même. Dans vos exemples, vous utilisiez na(value) pour cela.
La RMA, ou lissage de Wilder, commence de la même manière mais s’actualise autrement :
last_val = (last_val * (length - 1) + source) / length
return last_val
Pour dix, le poids de la nouvelle valeur est un dixième. Avec la même longueur, l’EMA lui accorde davantage de poids. Ces deux lissages réagissent donc différemment à la même série de prix.
Le code complet montre aussi la gestion d’une entrée manquante et le raccourci pour une longueur de un. Deux variantes utilisant la même formule peuvent différer si elles n’ont pas la même initialisation, le même traitement des absences ou les mêmes bougies d’exécution. L’ordre des opérations flottantes compte aussi ; conservez-le pour une comparaison précise.
RSI : deux variations lissées séparément
Le RSI traite séparément les hausses et les baisses de sa source. Voici les principales lignes de calcul de PyneCore :
rma_u = rma(builtins.max(source - prev_src, 0.0), length)
rma_d = rma(builtins.max(prev_src - source, 0.0), length)
prev_src = source
prev_src est la valeur source valide précédente, conservée dans une variable Persistent. Si le prix passe de 100 à 103, la hausse vaut 3 et la baisse 0. De 103 à 101, elles valent respectivement 0 et 2. Les deux séries sont lissées séparément par RMA ; chaque emplacement d’appel possède son propre état.
prev_src est actualisé après les deux différences. C’est l’ordre utilisé dans l’exercice sur la conservation de la valeur précédente.
Le RSI est construit à partir du rapport des deux variations lissées :
if rma_d <= 1e-10:
    return 100.0
if rma_u <= 1e-10:
    return 0.0

return 100 - 100 / (1 + rma_u / rma_d)
L’absence de baisse donne 100 ; l’absence de hausse donne 0. Le code traite aussi les valeurs très faibles et teste d’abord les baisses : si les deux côtés sont sous le seuil, le résultat vaut 100. Une formule seule ne montrerait pas ces détails.
Un premier prix valide ne donne pas encore de variation. Le RSI commence donc par le conserver et ne peut lancer les deux lissages qu’à la valeur suivante. Son initialisation dépend du nombre de variations. Le RSI n’est pas une probabilité : 70 ne signifie pas 70 % de chances de hausse.
MACD : construire un indicateur avec des moyennes
Le MACD calcule la différence entre deux EMA, puis une EMA de cette différence. Les principales étapes, sans les tests d’absence :
fast = ema(source, fastlen)
slow = ema(source, slowlen)
macd_val = fast - slow
signal = ema(macd_val, siglen)
Les trois valeurs renvoyées :
return macd_val, signal, macd_val - signalLa ligne MACD est la différence entre moyennes rapide et lente. La ligne de signal en est la version lissée. L’histogramme est la différence de ces deux lignes : il vaut zéro lorsqu’elles coïncident.
Un appel donne trois résultats, reçus dans trois variables :
macd_line, signal_line, histogram = ta.macd(close, 12, 26, 9)L’ordre compte : ligne MACD, ligne de signal, histogramme. Tant que les deux moyennes de prix ne sont pas prêtes, leur différence manque aussi. La ligne de signal a ensuite sa propre initialisation. Les absences initiales d’un indicateur composé découlent donc aussi de ses calculs internes.
ATR : intégrer aussi les sauts de prix
L’implémentation de l’ATR est courte :
return rma(tr(True), length)Vous connaissez la RMA ; elle lisse ici le True Range, ou amplitude vraie. C’est le maximum de trois distances :
- l’écart entre le plus haut et le plus bas actuels ;
- la distance entre le plus haut actuel et la clôture précédente ;
- la distance entre le plus bas actuel et la clôture précédente.
Avec une clôture précédente de 100, un plus bas actuel de 108 et un plus haut de 110, la bougie seule a une amplitude de 2. L’amplitude vraie vaut pourtant max(2, 10, 8), soit 10 : elle tient compte du saut depuis la clôture précédente.
À la première bougie, sans clôture précédente, tr(True) utilise high - low. Le code lit la clôture précédente dans une donnée interne fournie par l’environnement d’exécution. L’ATR montre l’ampleur du mouvement dans l’unité de prix, sans indiquer sa direction.
Bandes de Bollinger : moyenne et écart-type
La ligne centrale de ta.bb est une SMA ; ses limites en sont éloignées d’un multiple donné de l’écart-type. Le code calcule d’abord l’écart-type et la moyenne :
std_dev = stdev(series, length)
middle = sma(series, length)
Avec une valeur centrale valide, il renvoie :
std_dev *= mult
return middle, middle + std_dev, middle - std_dev
L’écart-type décrit la dispersion des valeurs de la fenêtre autour de la moyenne. Avec un centre à 100, un écart-type de 3 et un multiplicateur de 2, la limite supérieure est 106 et l’inférieure 94. L’appel renvoie aussi trois valeurs, dans un ordre différent du MACD : centre, limite supérieure, limite inférieure.
Votre variante : reproduire d’abord l’original
Créez bands_workshop.py. Notre fonction assemble les bandes à partir d’éléments plus simples de la bibliothèque. Nous calculons aussi la limite supérieure de ta.bb pour disposer d’une référence.
"""
@pyne edge
"""
from pynecore.lib import close, color, input, plot, script, ta


def custom_bands(source: float, length: int, multiplier: float) -> tuple[float, float, float]:
    middle = ta.sma(source, length)
    deviation = ta.stdev(source, length)
    upper = middle + multiplier * deviation
    lower = middle - multiplier * deviation
    return middle, upper, lower


@script.indicator("Bands Workshop", overlay=True)
def main(
    length: int = input.int(20, title="Length", minval=2, maxval=200),
    multiplier: float = input.float(2.0, title="Deviation multiplier", minval=0.1, maxval=5.0),
):
    builtin_middle, builtin_upper, builtin_lower = ta.bb(close, length, multiplier)
    own_middle, own_upper, own_lower = custom_bands(close, length, multiplier)
    plot(builtin_upper, "Built-in upper", color=color.blue, linewidth=3)
    plot(own_upper, "Custom upper", color=color.orange)
    plot(own_middle, "Custom middle", color=color.green)
    plot(own_lower, "Custom lower", color=color.gray)
tuple[float, float, float] indique un résultat composé de trois nombres. return middle, upper, lower renvoie ce triplet ; les trois noms de variables avant l’appel reçoivent ses valeurs séparément. Nous ne traçons pas encore builtin_middle ni builtin_lower, mais vous pourrez aussi les utiliser pour vérifier.
Exécutez sur les données de démonstration. Votre limite supérieure coïncide avec celle de la bibliothèque ; la fine ligne orange suit l’épaisse ligne bleue. Placez le pointeur sur une bougie et comparez Built-in upper et Custom upper. Pour une longueur de vingt, les dix-neuf premières bougies n’ont pas encore de fenêtre complète.
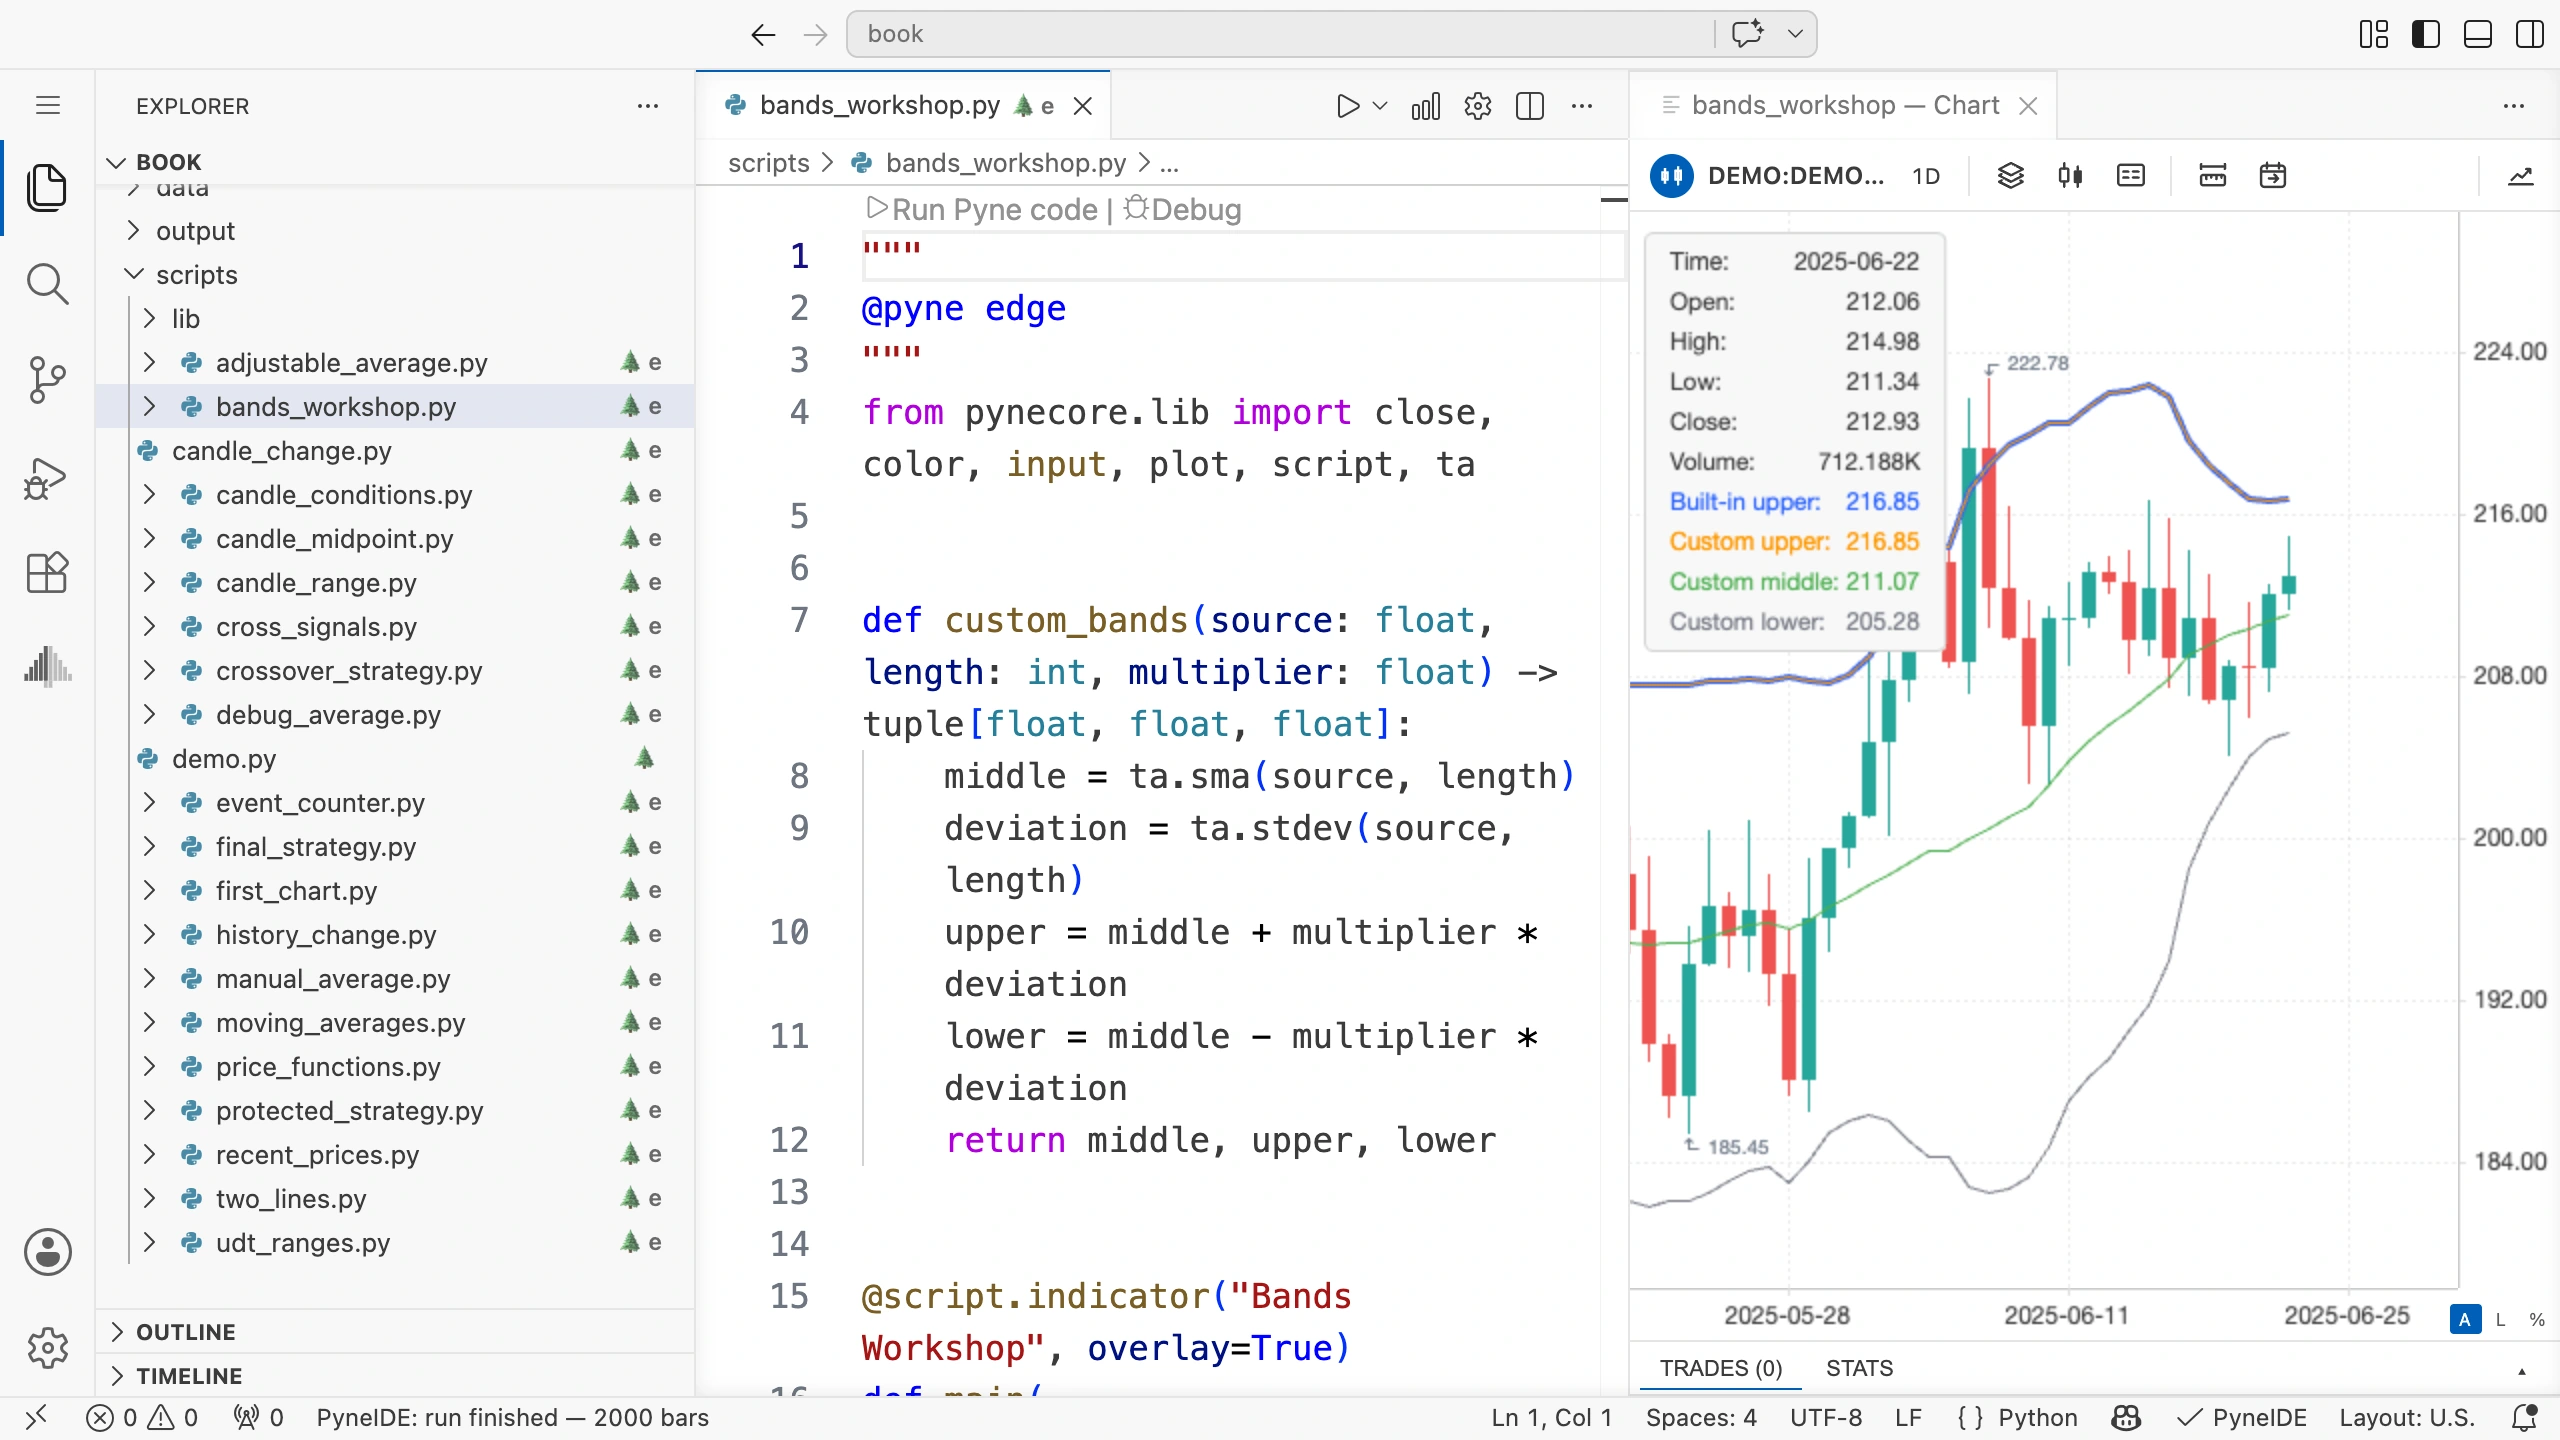
Pour une vérification plus précise, ouvrez les valeurs enregistrées avec Open plot output CSV dans la barre d’outils du graphique. Pour une variante, vérifiez le premier point valide et les valeurs suivantes. Des lignes visuellement identiques peuvent encore présenter un petit écart.
À vous de jouer : une ligne centrale EMA
Modifiez seulement le centre de custom_bands : utilisez une EMA au lieu d’une SMA. Conservez le calcul d’écart-type et l’appel existant à ta.bb pour comparer.
Avant l’exécution, prévoyez : votre limite supérieure coïncidera-t-elle toujours avec l’originale ? Que se passera-t-il après une variation brusque ?
Solution de l’exercice
La première ligne de calcul de votre fonction :
middle = ta.ema(source, length)Les deux limites sont mesurées depuis cette EMA ; ta.stdev reste inchangée. Votre centre et vos limites se décalent donc généralement par rapport aux bandes originales. La différence entre les limites supérieures est égale à celle entre EMA et SMA, car on leur ajoute le même écart-type avec le même multiplicateur.
C’est désormais votre variante expérimentale. Une ligne différente ne démontre pas à elle seule qu’une règle de trading donnera de meilleurs résultats ; cela se vérifie dans une stratégie séparée, sur les mêmes données et avec les mêmes réglages.
Poursuivre l’étude de la bibliothèque
Choisissez un indicateur et décrivez avec vos mots ses entrées, ce qu’il mémorise et son résultat. Suivez les appels internes jusqu’à comprendre l’ensemble du calcul. Pour le RSI, par exemple, le chemin rsi → rma → sma mène des différences au lissage, puis à l’initialisation.
Lisez aussi les branches concernant les valeurs manquantes, l’initialisation et les cas limites. Pour une variante, changez d’abord un seul détail, puis comparez les résultats avec l’original. Vous pourrez distinguer l’effet volontaire d’une erreur de calcul.
Les autres fonctions de la bibliothèque sont accessibles par le même Command-clic ou Ctrl-clic. Un indicateur plus long demandera peut-être davantage de temps, mais la méthode reste la même : entrées, données conservées, calcul, résultat.