आगे का विषय: इंडिकेटर भीतर कैसे काम करते हैं?
SMA, EMA, RSI, MACD, ATR और Bollinger बैंड का स्रोत पढ़ें और अपना रूप बनाएँ।
वैल्यू कैसे बनती है समझें तो इंडिकेटर को आगे बदलना आसान है। गणना में क्या आता है? अगली कैंडल के लिए क्या याद रहता है? दूसरा औसत या कीमत स्रोत लेने से क्या बदलेगा? सोर्स कोड इनका भी जवाब देता है।
PyneCore की ta लाइब्रेरी Pyne code में लिखी है। उसमें Persistent, फ़ंक्शन कॉल और शर्तें किताब वाले व्यवहार पर चलती हैं। पूरा स्रोत उपलब्ध है, इसलिए तैयार इंडिकेटर को भी अपने प्रोग्राम की तरह समझ सकते हैं।
यह आगे का अध्याय है: स्रोत पढ़ना और प्रयोग करना सीखेंगे। पूरी लाइब्रेरी एक साथ समझना नहीं है। छोटे फ़ंक्शन से शुरू करके उसके अंदर की कॉल देखें।
असली कार्यान्वयन खोलें
- पहले की
moving_averages.pyPyneIDE में खोलें। ta.ema(close, 10)में macOS पर Command, Windows या Linux पर Ctrl दबाकरemaपर क्लिक करें। दाएँ-क्लिक का Go to Definition भी है।- एडिटर इंस्टॉल PyneCore की
ta.pyमेंemaकी परिभाषा खोलता है। - पहले विवरण, फिर बॉडी पढ़ें। दूसरे फ़ंक्शन की कॉल हो तो उसकी परिभाषा भी खोलें।
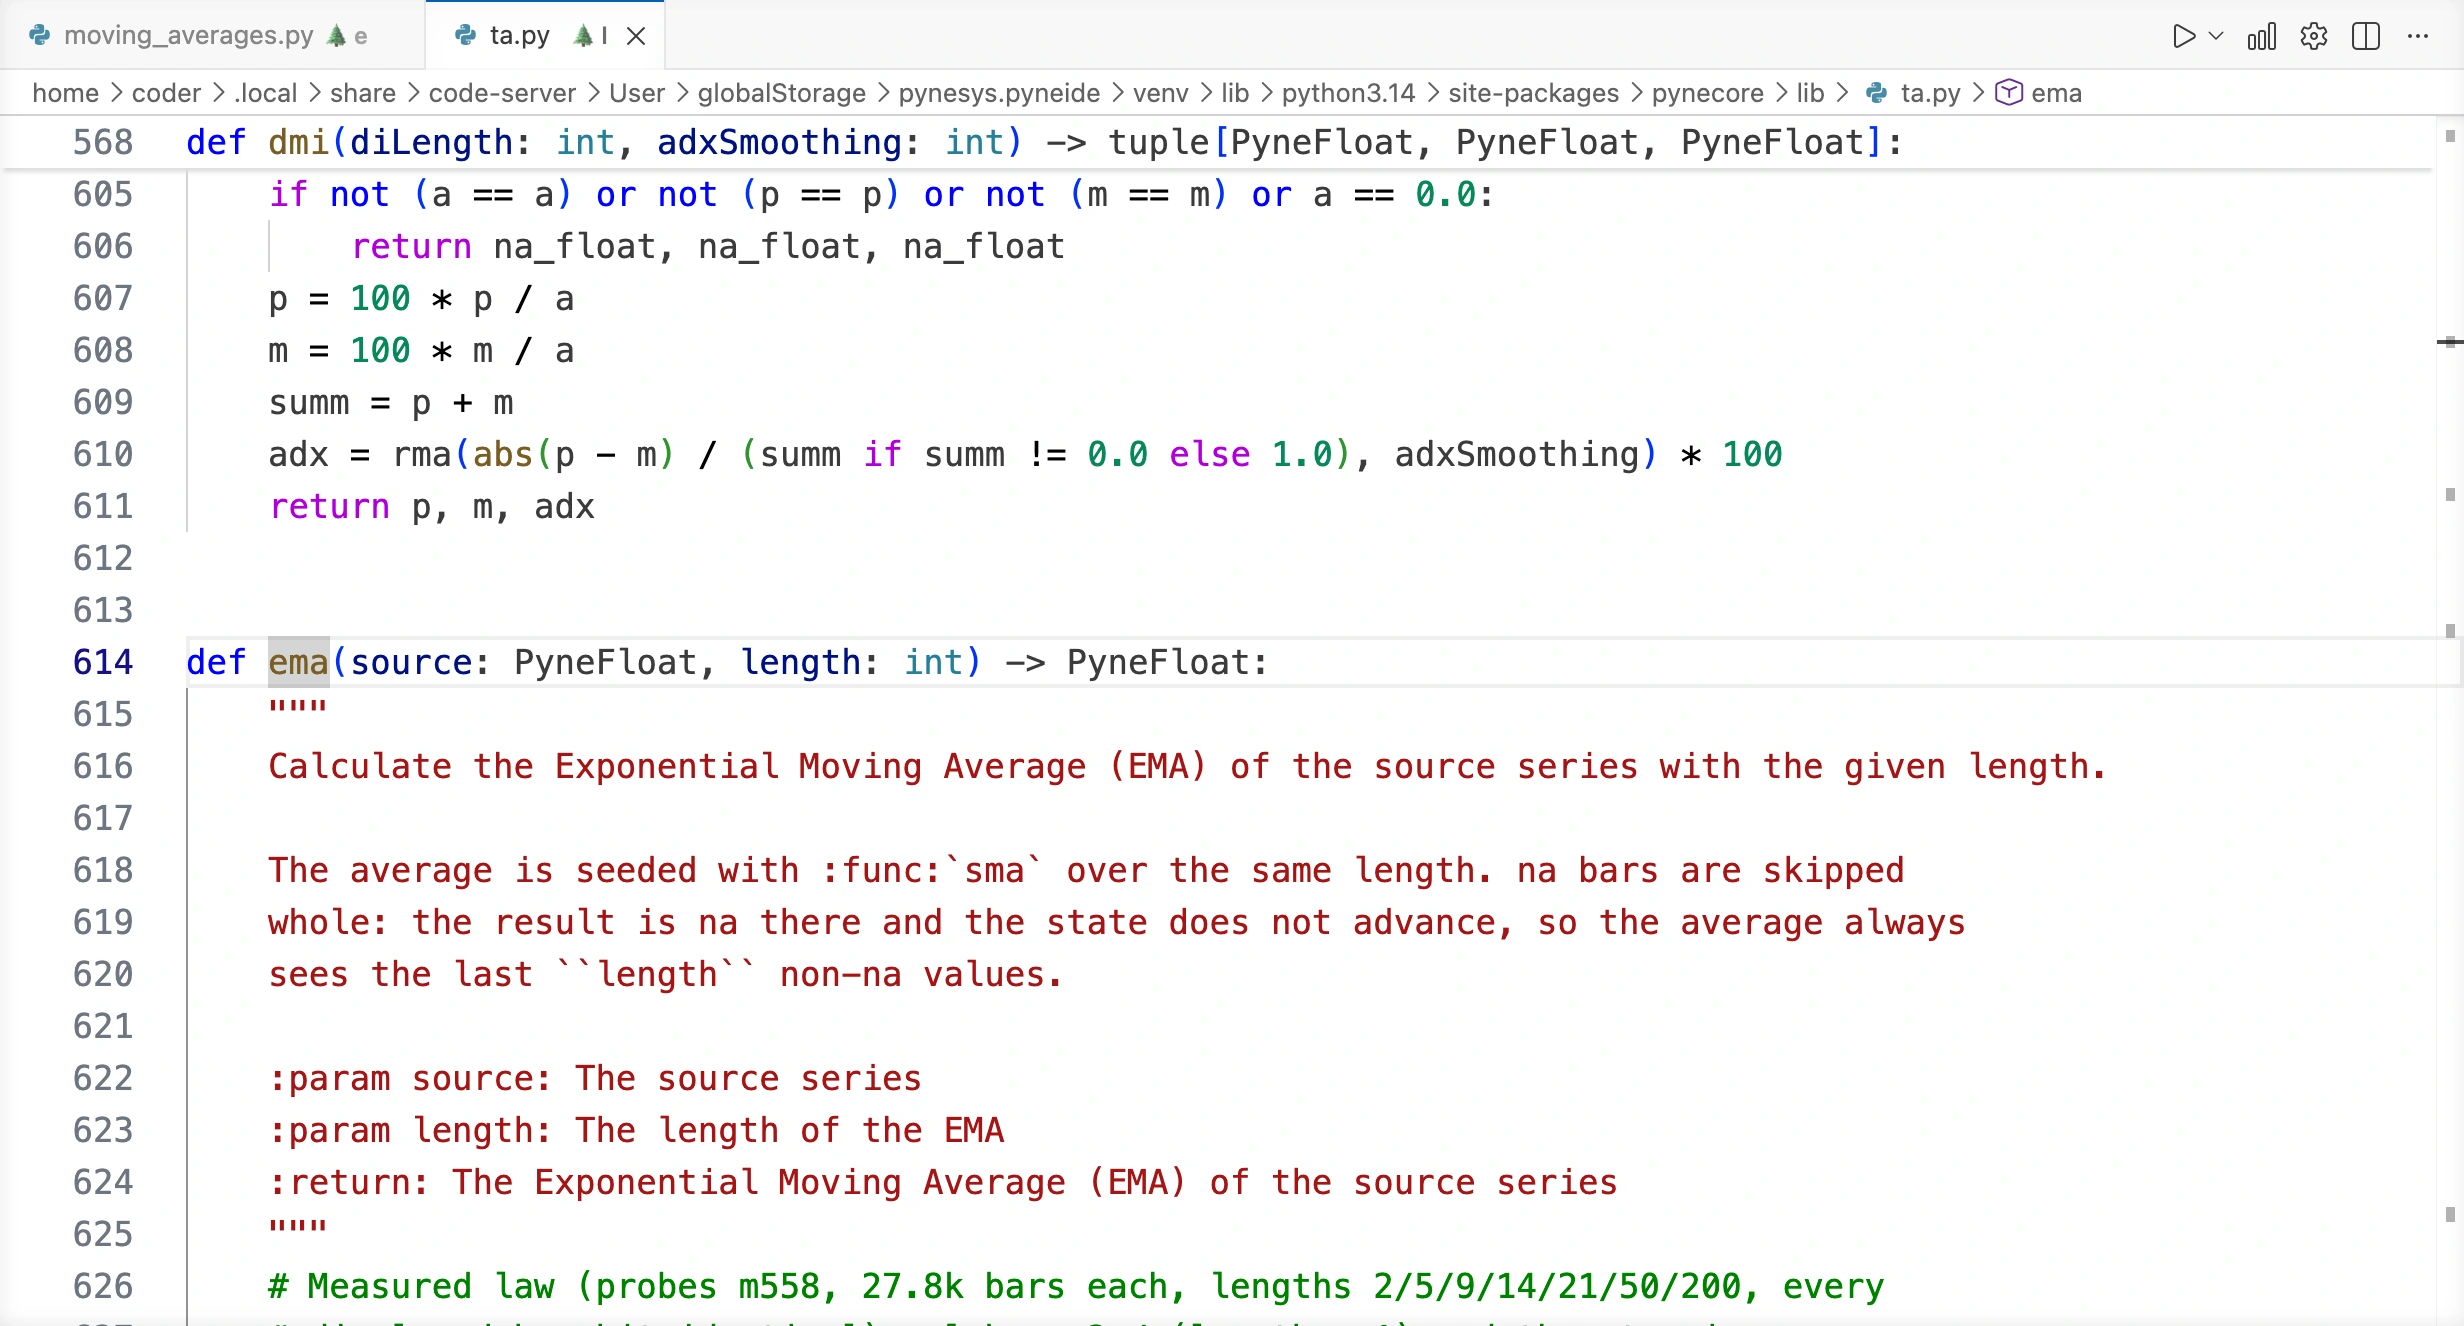
कोड लिखते समय मदद में पैरामीटर और परिभाषा देख चुके हैं। यही RSI, MACD और बाकी स्रोत खोलता है। पूरी ta रेफ़रेंस फ़ंक्शन खोजने और पैरामीटर समझने में मदद करती है।
लाइब्रेरी कोड और Edge: ta.py की शुरुआत @pyne lib से है। लाइब्रेरी Edge के सीमित नियमों में नहीं बनी: सामान्य Python साधन, आंतरिक सहायक फ़ंक्शन और अतिरिक्त टाइप भी हैं। लेकिन कैंडल-दर-कैंडल व्यवहार और स्टेट परिचित लगेंगे। जैसे PyneFloat लाइब्रेरी का नंबर टाइप चिह्न और na_float गायब नंबर है।
नीचे अंश लाइब्रेरी की गणना हैं, पूरे Edge प्रोग्राम नहीं। अपना Edge रूप बनाते समय समझे एल्गोरिदम को अनुमत साधनों से लिखें। इंस्टॉल ta.py न बदलें; अपनी फ़ाइल में प्रयोग करें।
SMA: सूत्र के पीछे का जोड़
ta.sma की दो लाइनें:
length = int(length)
return lib_math.sum(source, length) / length
औसत विंडो का जोड़ तत्व संख्या से भाग देने पर है। लंबाई पूर्णांक करने के बाद lib_math.sum जोड़ता है। स्टेट sma की बॉडी में नहीं, बुलाए जोड़ में है। कॉल आगे देखें तो math.py से _math_stateful.py पहुँचते हैं।
पढ़ने की आदत बनाएँ: छोटा फ़ंक्शन भी स्टेट वाला हो सकता है। अंदर के फ़ंक्शन भी गणना का हिस्सा हैं। हाथ से बना औसत उसी विंडो को अपने लूप से जोड़ता था।
EMA और RMA: बचा औसत अपडेट करना
वार्म-अप के बाद EMA:
last_val = last_val + alpha * (source - last_val)
return last_val
last_val पुराना औसत और source अभी की वैल्यू है। अंतर का कुछ हिस्सा पुराने औसत में जोड़ते हैं। EMA में alpha = 2 / (length + 1)। दस पर नई कीमत और पुराने औसत के अंतर का लगभग 18.18 प्रतिशत जोड़ते हैं।
सोर्स में alpha और last_val दोनों Persistent हैं। शुरू में last_val गायब है, इसलिए समान लंबाई की SMA से भरने की कोशिश है:
if not (last_val == last_val):
    last_val = sma(source, length)
    return last_val
SMA का डेटा पूरा न हो तो नतीजा गायब है। शुरुआती औसत के बाद पुरानी वैल्यू अपडेट करते हैं। not (last_val == last_val) गायब होने की जाँच है: अनुपलब्ध वैल्यू स्वयं के बराबर नहीं। अपने उदाहरण में na(value) लिया था।
RMA, यानी Wilder की स्मूदिंग, वैसे ही शुरू होकर अलग अपडेट है:
last_val = (last_val * (length - 1) + source) / length
return last_val
दस की लंबाई पर नई वैल्यू का वज़न एक-दसवाँ है। उसी लंबाई की EMA में अधिक है। इसलिए एक कीमत श्रृंखला पर प्रतिक्रिया अलग है।
पूरे स्रोत में गायब इनपुट और एक की लंबाई का छोटा रास्ता भी है। वही सूत्र होने पर भी शुरुआत, गायब डेटा या चलने वाली कैंडल अलग हों तो नतीजा बदलेगा। फ़्लोटिंग-पॉइंट काम का क्रम भी मायने रखता है; सटीक तुलना के लिए रखें।
RSI: दो अलग स्मूद बदलाव
RSI बढ़त और गिरावट अलग संभालता है। PyneCore की मुख्य लाइनें:
rma_u = rma(builtins.max(source - prev_src, 0.0), length)
rma_d = rma(builtins.max(prev_src - source, 0.0), length)
prev_src = source
prev_src पिछली वैध स्रोत वैल्यू है जिसे Persistent रखता है। 100 से 103 पर बढ़त 3 और गिरावट 0। 103 से 101 पर क्रमशः 0 और 2। दोनों सीरीज़ अलग RMA से स्मूद हैं; दोनों कॉल का अलग स्टेट है।
prev_src दोनों अंतर के बाद अपडेट है। यही पिछली वैल्यू बचाने वाले अतिरिक्त अभ्यास का क्रम था।
दो स्मूद बदलाव के अनुपात से RSI:
if rma_d <= 1e-10:
    return 100.0
if rma_u <= 1e-10:
    return 0.0

return 100 - 100 / (1 + rma_u / rma_d)
गिरावट न हो तो 100, बढ़त न हो तो 0। सोर्स बहुत छोटी वैल्यू भी संभालता और पहले गिरावट देखता है: दोनों सीमा से नीचे हों तो 100। केवल सूत्र से ये बातें नहीं मिलतीं।
पहली वैध कीमत से बदलाव नहीं है। RSI पहले बचाता है और अगली से दोनों स्मूदिंग शुरू कर सकता है। वार्म-अप बदलाव की संख्या से तय है। RSI संभावना नहीं: 70 का मतलब बढ़ने की 70 प्रतिशत संभावना नहीं।
MACD: औसत से नया इंडिकेटर
MACD दो EMA का अंतर और उसका भी EMA बनाता है। गायब वैल्यू जाँच के बिना मुख्य चरण:
fast = ema(source, fastlen)
slow = ema(source, slowlen)
macd_val = fast - slow
signal = ema(macd_val, siglen)
तीन लौटती वैल्यू:
return macd_val, signal, macd_val - signalMACD लाइन तेज़ और धीमे औसत का अंतर है। सिग्नल उसका स्मूद रूप है। हिस्टोग्राम दोनों का अंतर, इसलिए समान होने पर शून्य।
एक कॉल के तीन नतीजे तीन वेरिएबल में:
macd_line, signal_line, histogram = ta.macd(close, 12, 26, 9)क्रम मायने रखता है: MACD, सिग्नल, हिस्टोग्राम। दोनों कीमत औसत बनने तक अंतर भी गायब है। फिर सिग्नल का अपना वार्म-अप है। जटिल इंडिकेटर की शुरुआती कमी अंदर की गणना से भी आती है।
ATR: कीमत की छलाँग भी रेंज में
ATR छोटा है:
return rma(tr(True), length)RMA जानते हैं; यहाँ True Range, यानी वास्तविक रेंज, स्मूद करता है। तीन दूरी का अधिकतम है:
- अभी के हाई और लो का अंतर;
- अभी के हाई से पिछली क्लोज़ की दूरी;
- अभी के लो से पिछली क्लोज़ की दूरी।
पिछली क्लोज़ 100, अभी लो 108 और हाई 110 हो तो कैंडल की रेंज 2 है। असली रेंज max(2, 10, 8), यानी 10: पिछली क्लोज़ से छलाँग भी लेती है।
पहली कैंडल में पिछली क्लोज़ न हो तो tr(True), high - low लेता है। सोर्स पिछली क्लोज़ रनटाइम के आंतरिक डेटा से पढ़ता है। ATR कीमत इकाई में चाल का आकार देता है, दिशा नहीं।
Bollinger बैंड: औसत और मानक विचलन
ta.bb का मध्य SMA है; दोनों सीमाएँ उससे मानक विचलन के दिए गुणक जितनी दूर हैं। पहले विचलन और औसत:
std_dev = stdev(series, length)
middle = sma(series, length)
वैध मध्य पर लौटता है:
std_dev *= mult
return middle, middle + std_dev, middle - std_dev
मानक विचलन बताता है कि विंडो की वैल्यू औसत के आसपास कितनी फैली हैं। मध्य 100, विचलन 3, गुणक 2 हो तो ऊपर 106 और नीचे 94 है। तीन वैल्यू हैं, लेकिन MACD से अलग क्रम: मध्य, ऊपर, नीचे।
अपना रूप: पहले मूल नतीजा दोहराएँ
bands_workshop.py बनाएँ। अपना फ़ंक्शन सरल लाइब्रेरी हिस्सों से बैंड बनाता है। तुलना के लिए तैयार ta.bb की ऊपरी सीमा भी निकालते हैं।
"""
@pyne edge
"""
from pynecore.lib import close, color, input, plot, script, ta


def custom_bands(source: float, length: int, multiplier: float) -> tuple[float, float, float]:
    middle = ta.sma(source, length)
    deviation = ta.stdev(source, length)
    upper = middle + multiplier * deviation
    lower = middle - multiplier * deviation
    return middle, upper, lower


@script.indicator("Bands Workshop", overlay=True)
def main(
    length: int = input.int(20, title="Length", minval=2, maxval=200),
    multiplier: float = input.float(2.0, title="Deviation multiplier", minval=0.1, maxval=5.0),
):
    builtin_middle, builtin_upper, builtin_lower = ta.bb(close, length, multiplier)
    own_middle, own_upper, own_lower = custom_bands(close, length, multiplier)
    plot(builtin_upper, "Built-in upper", color=color.blue, linewidth=3)
    plot(own_upper, "Custom upper", color=color.orange)
    plot(own_middle, "Custom middle", color=color.green)
    plot(own_lower, "Custom lower", color=color.gray)
tuple[float, float, float] तीन नंबर वाले नतीजे का टाइप है। return middle, upper, lower वही तीन देता है; कॉल से पहले तीन नाम उन्हें अलग लेते हैं। builtin_middle और builtin_lower अभी नहीं दिखाते, लेकिन आगे जाँच सकते हैं।
डेमो पर चलाएँ। अपनी और तैयार ऊपरी सीमा मिलती हैं; मोटी नीली पर पतली नारंगी है। कैंडल पर माउस रखकर Built-in upper और Custom upper मिलाएँ। बीस पर पहली उन्नीस में पूरी विंडो नहीं।
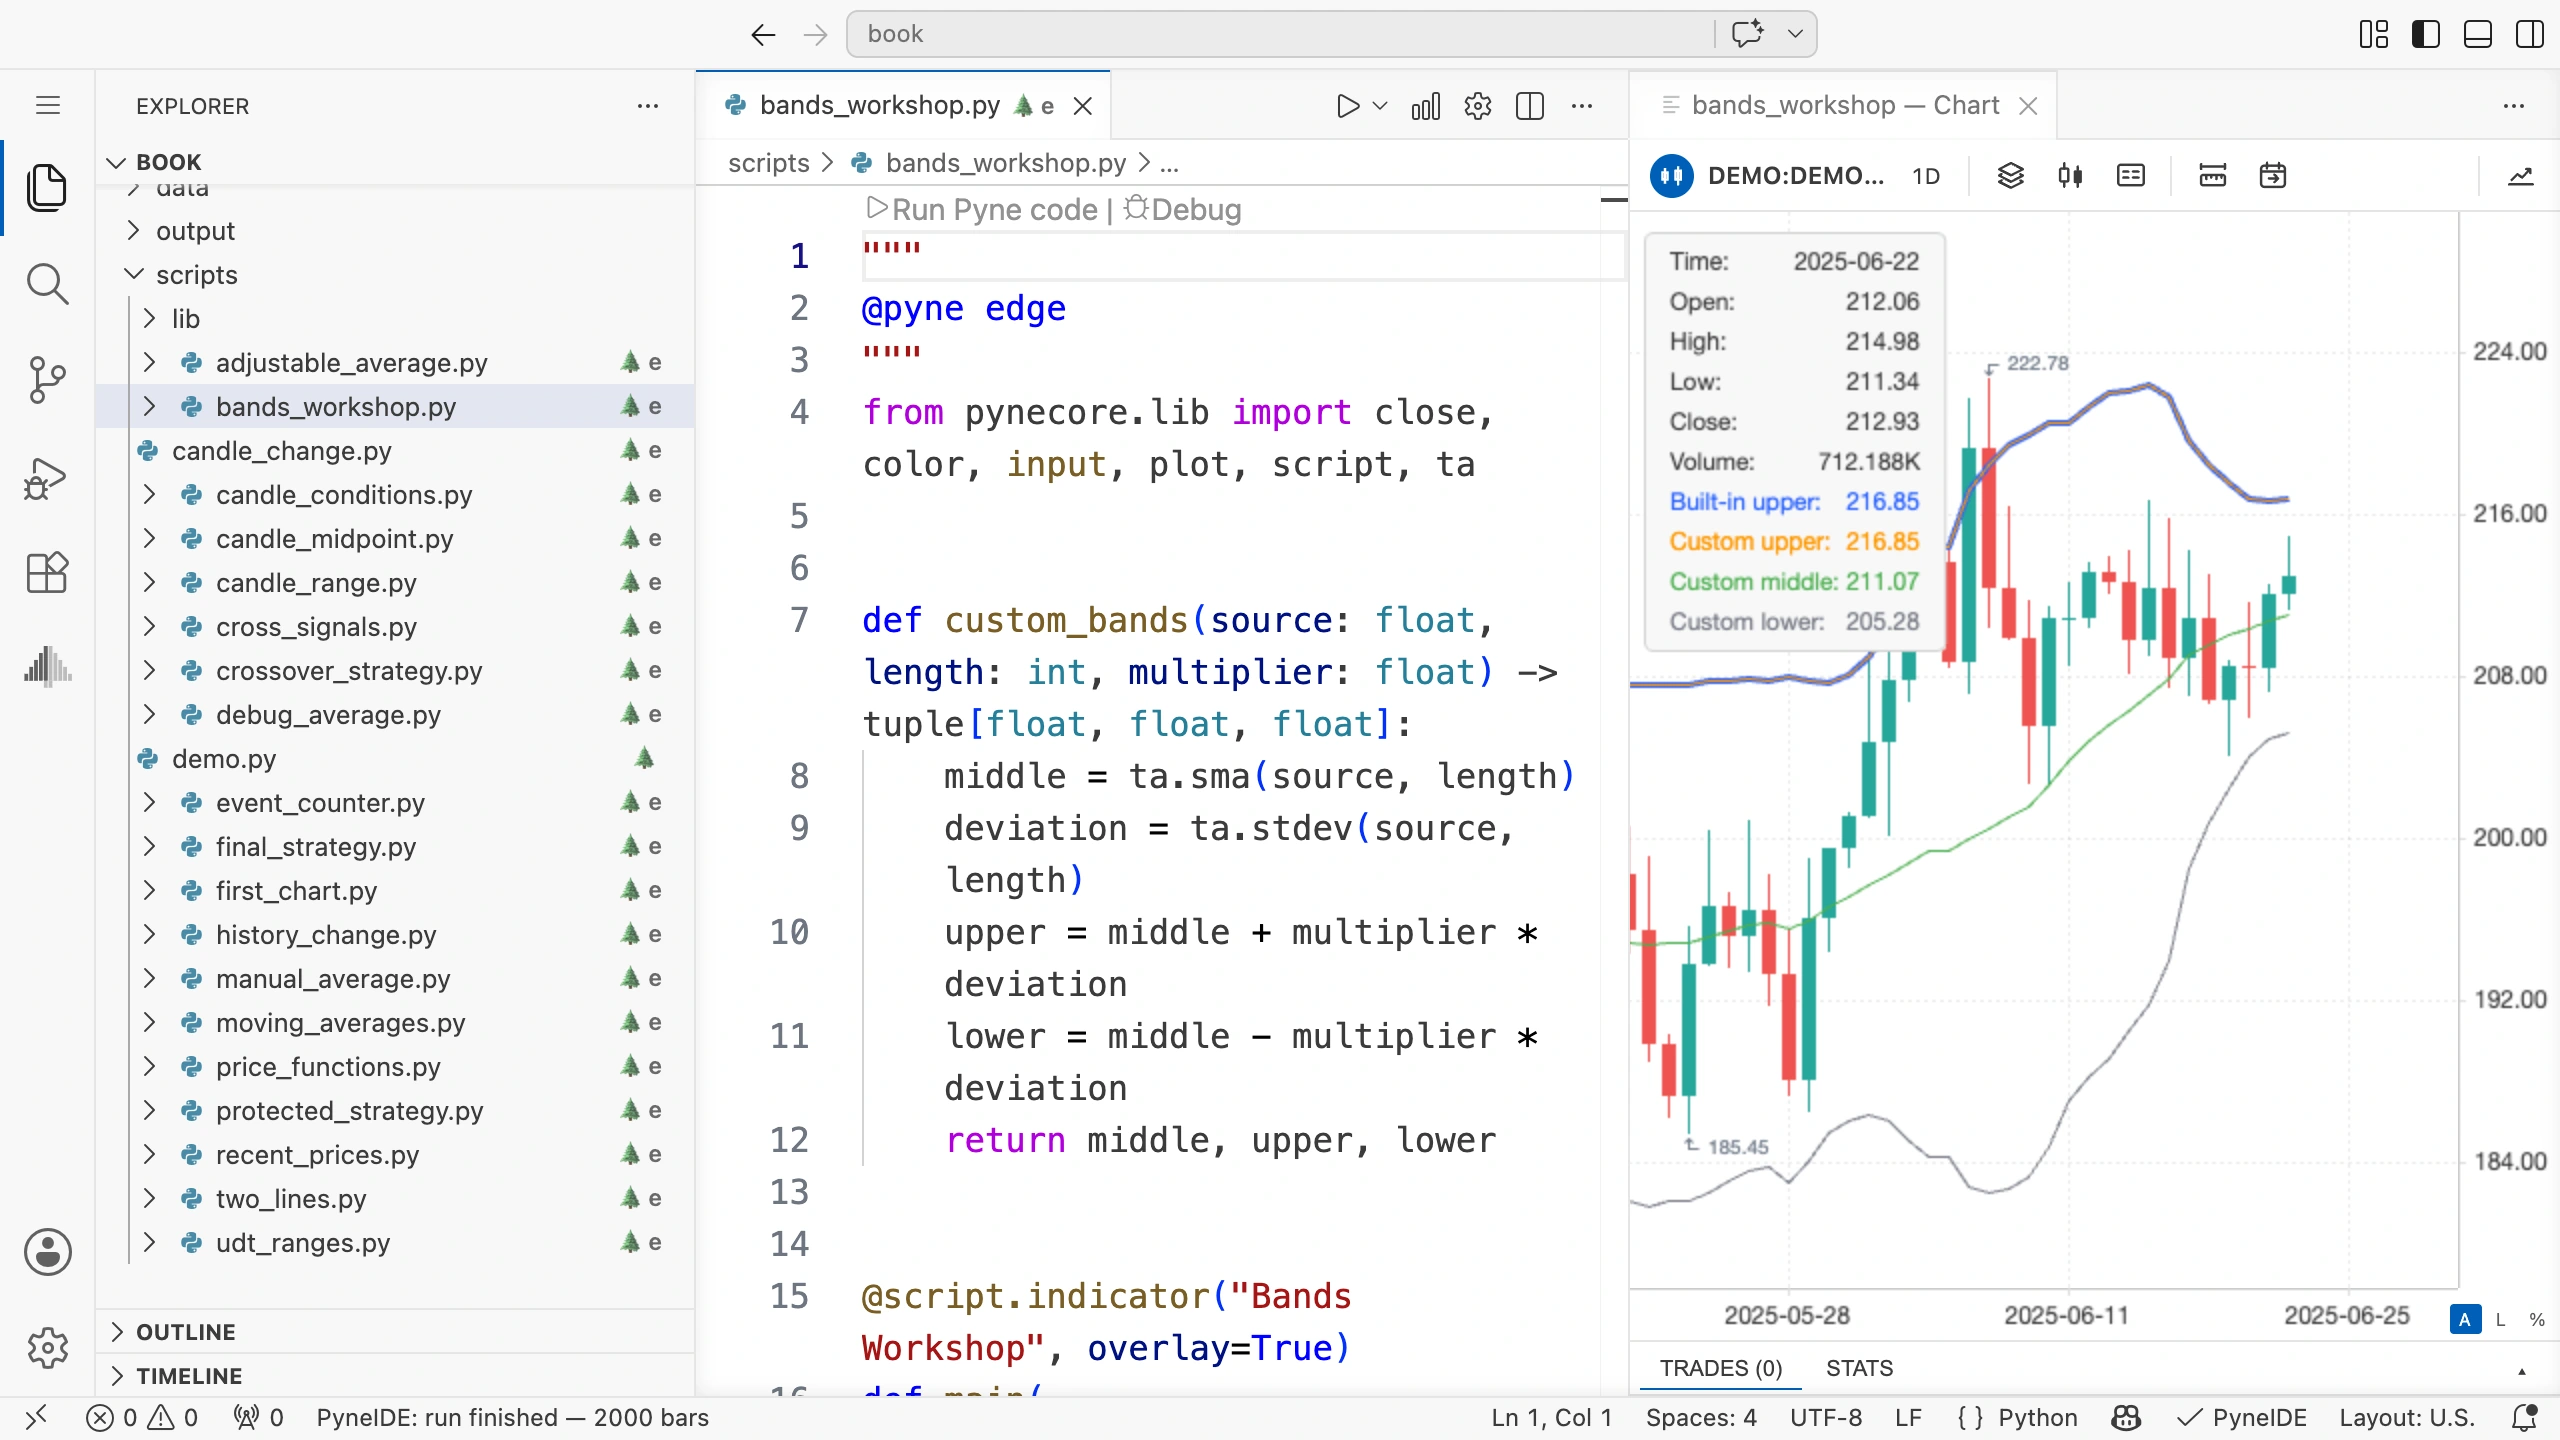
अधिक सटीक जाँच के लिए टूलबार का Open plot output CSV खोलें। पहली वैध और बाद की वैल्यू देखें। देखने में समान लाइन में भी छोटा अंतर हो सकता है।
स्वयं करके देखें: EMA मध्यरेखा
केवल custom_bands का मध्य SMA से EMA करें। विचलन और तैयार ta.bb तुलना के लिए रखें।
पहले अनुमान लगाएँ: अपनी ऊपरी सीमा पूरी तरह तैयार से मिलेगी? अचानक कीमत बदलने पर क्या होगा?
अभ्यास का हल
अपने फ़ंक्शन की पहली गणना:
middle = ta.ema(source, length)दोनों सीमाएँ इस EMA से मापते हैं; ta.stdev वही है। इसलिए मध्य और सीमाएँ आमतौर पर मूल से खिसकती हैं। दोनों ऊपर की वैल्यू का अंतर EMA-SMA अंतर जैसा है, क्योंकि समान विचलन और गुणक जोड़ते हैं।
यह आपका प्रयोग वाला रूप है। अलग लाइन अकेले बेहतर ट्रेडिंग नतीजा नहीं बताती; अलग रणनीति में समान डेटा और सेटिंग से जाँचें।
लाइब्रेरी में आगे कैसे बढ़ें
एक इंडिकेटर चुनकर अपने शब्दों में लिखें कि क्या लेता, याद रखता और लौटाता है। भीतर की कॉल तब तक देखें जब तक पूरी गणना समझ आए। RSI में rsi → rma → sma से अंतर, स्मूदिंग और शुरुआत तक जाएँगे।
गायब वैल्यू, वार्म-अप और सीमा के मामले भी पढ़ें। अपना रूप बनाते समय एक चीज़ बदलें और मूल से मिलाएँ। जानबूझकर बदलाव और त्रुटि अलग कर सकेंगे।
बाकी स्रोत भी Command-क्लिक या Ctrl-क्लिक से मिलते हैं। लंबा इंडिकेटर समय ले सकता है, लेकिन तरीका वही है: इनपुट, बचा डेटा, गणना, नतीजा।